Отказ сервера с базой данных едва ли не самый тяжелый сбой, который способен возникнуть в любой IT-системе, ведь он может остановить весь проект. Если само приложение иногда удаётся восстановить за несколько минут, то вот с базой всё гораздо сложнее, так как необходимы актуальные данные, а последняя резервная копия могла быть сделана несколько часов назад.
Одним из лучших способов для сокращения времени простоя является репликация базы данных между двумя серверами и в данной статье мы будем рассматривать этот вопрос на примере СУБД PostgreSQL и двух VPS-серверов. Основной сервер будет обрабатывать запросы приложения, а резервный будет постоянно получать изменения базы данных с основного сервера. И в случае, если основной VPS выходит из строя, то резервный можно будет перевести в рабочий режим.
Давайте в этой инструкции настроим физическую потоковую репликацию PostgreSQL 16 на двух VPS серверах, работающих на Ubuntu 24.04, после чего проверим передачу данных, разберём типичные ошибки и подготовим ручное переключение на резервный VPS.
В отличие от других наших статей - данная будет сопровождаться минимумом комментариев и максимумом практичных действий. Поехали.
Как работает репликация PostgreSQL
Для передачи изменений PostgreSQL использует так называемый журнал предзаписи - WAL (Write-Ahead Log). Когда приложение добавляет или изменяет данные, то информация об операции записывается в WAL. Резервный сервер получает эти записи и воспроизводит изменения.
Этот механизм называется Streaming Replication.
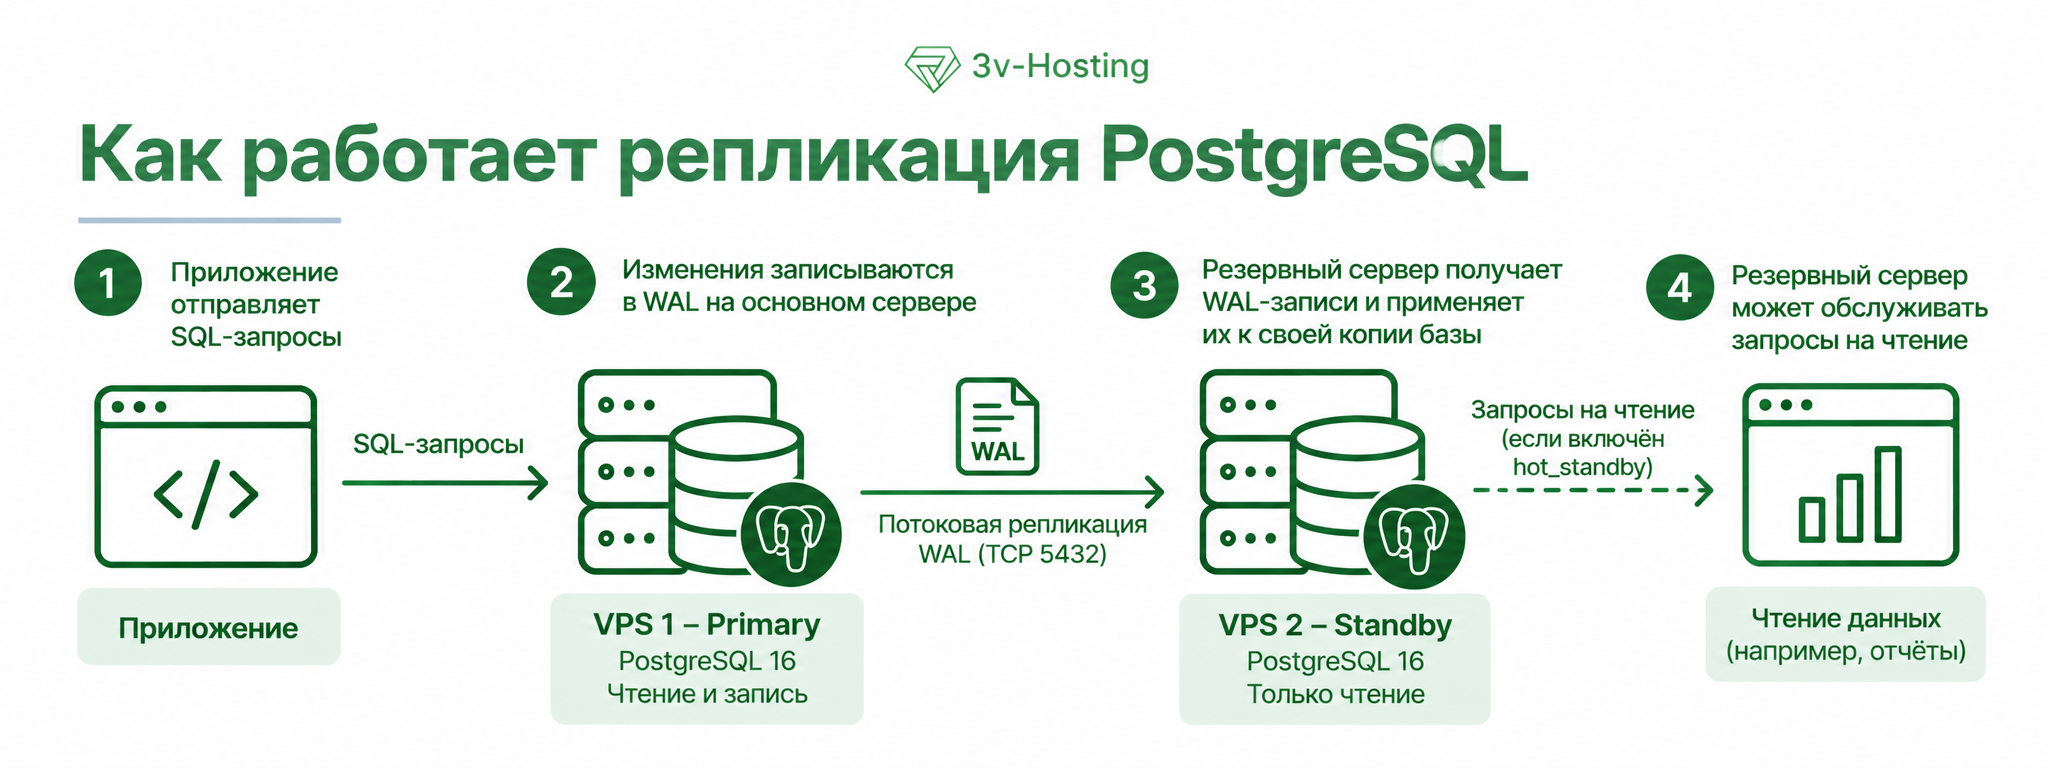
Primary принимает запросы на чтение и запись, а Standby получает WAL-записи и применяет их к своей копии базы.
Если включён параметр hot_standby (в PostgreSQL 16 он включён по умолчанию в значение on), то резервный сервер может обслуживать запросы на чтение. Например, на него можно перенести формирование отчётов, хотя длительные запросы иногда мешают своевременному применению WAL.
Есть и ограничение. Удаление таблицы, ошибочный UPDATE или повреждение данных на логическом уровне могут попасть на реплику. Поэтому для восстановления после ошибок нужны отдельные резервные копии, желательно с поддержкой Point-in-Time Recovery (PITR).
Подготовка двух VPS
Для примера используем следующую конфигурацию серверов:
| Параметр |
Primary |
Standby |
| Операционная система |
Ubuntu 24.04 |
Ubuntu 24.04 |
| PostgreSQL |
16 |
16 |
| IP-адрес |
10.10.0.11 |
10.10.0.12 |
| Роль |
Чтение и запись |
Только чтение |
| TCP-порт |
5432 |
5432 |
IP-адреса здесь указаны условные, но предполагается, что оба VPS подключены к одной приватной сети. При этом крайне желательно разместить серверы на разных физических узлах, иначе неисправность одного гипервизора способна одновременно отключить Primary и Standby. Мы думаем, что тут всё понятно.
Установка PostgreSQL 16
На обоих серверах выполняем команды:
sudo apt update
sudo apt install postgresql-16 postgresql-client-16
Проверяем версию:
psql --version
Ожидаемый результат:
psql (PostgreSQL) 16.x
В ОС Ubuntu база данных PostgreSQL управляется через postgresql-common. Утилита pg_lsclusters показывает конкретные кластеры, их порты и каталоги данных. Поэтому теперь мы можем посмотреть состояние кластера командой:
sudo pg_lsclusters
Пример вывода:
Ver Cluster Port Status Owner    Data directory
16  main    5432 online postgres /var/lib/postgresql/16/main
Для физической репликации оба сервера должны использовать одну основную версию PostgreSQL. В нашем случае - это версия 16. Минорные версии, конечно, могут различаться, хотя, всё таки, обновлять оба экземпляра лучше своевременно.
Настройка Primary
Начнём настройку с основного VPS-сервера с IP-адресом 10.10.0.11.
Изменение postgresql.conf
Открываем конфигурацию:
sudo nano /etc/postgresql/16/main/postgresql.conf
Находим параметры и устанавливаем значения, как указано ниже:
listen_addresses = '10.10.0.11,localhost'
wal_level = replica
max_wal_senders = 10
max_replication_slots = 10
wal_keep_size = 1024MB
Кратко поясним, что означают эти настройки:
| Параметр |
Назначение |
listen_addresses |
Адреса для входящих подключений |
wal_level |
Уровень WAL для физической репликации |
max_wal_senders |
Максимальное количество процессов передачи WAL |
max_replication_slots |
Максимальное количество слотов репликации |
wal_keep_size |
Минимальный объём старых WAL-сегментов, сохраняемых для реплик |
wal_keep_size = 1024MB задаёт минимальный запас WAL примерно в 1 ГБ. Это значение подходит для примера, но при интенсивной записи такой запас может закончиться быстро.
Сам параметр не ограничивает максимальный размер каталога pg_wal.
ВАЖНО! В рамках данной статьи мы лишь приводим пример конфигурации, а вот реальные значения параметров для вашей системы будет зависеть от многих факторов, включая нагрузку на сервер, нагрузку на базу данных, мощность самого сервера и т.п.
Создание пользователя для репликации
Создадим отдельную роль, через которую Standby будет подключаться к Primary.
sudo -u postgres psql
В консоли PostgreSQL выполняем запрос:
CREATE ROLE replicator
WITH REPLICATION LOGIN
PASSWORD 'StrongReplicationPassword';
ВАЖНО! Замените пароль собственным.
Роль replicator получает право на репликацию без полномочий суперпользователя.
Проверяем:
\du replicator
Выходим:
\q
Настройка pg_hba.conf
Теперь разрешим подключения к нашему основному серверу с резервного VPS. Открываем файл:
sudo nano /etc/postgresql/16/main/pg_hba.conf
Добавляем:
host replication replicator 10.10.0.12/32 scram-sha-256
Это правило разрешает физическую репликацию пользователю replicator с адреса 10.10.0.12. Ну и поскольку правила pg_hba.conf проверяются сверху вниз, убедитесь, что более ранние записи не перехватывают это подключение.
Перезапускаем PostgreSQL:
sudo pg_ctlcluster 16 main restart
Проверяем, что кластер запустился:
sudo pg_lsclusters
Открытие порта 5432
Если на Primary используется файервол UFW, то нам необходимо разрешить подключение со второго VPS:
sudo ufw allow from 10.10.0.12 to any port 5432 proto tcp
Проверяем правила:
sudo ufw status
Очевидно, что открывать порт 5432 для всех адресов не нужно - это небезопасно.
После добавления правила, на Standby - на втором, резервном VPS, проверяем TCP-соединение к основному, Primary серверу:
nc -vz -w 3 10.10.0.11 5432
Если nc на сервере по умолчанию отсутствует, то установите его командой:
sudo apt install netcat-openbsd
При успешном подключении появится примерно такое сообщение:
Connection to 10.10.0.11 5432 port [tcp/postgresql] succeeded!
Это подтверждает только доступность конкретного порта, а вот проверку аутентификации мы проведём при создании реплики.
Создание Standby на втором VPS
Теперь настроим сервер 10.10.0.12.
Для получения первоначальной копии базы используем утилиту pg_basebackup. Она скопирует файлы PostgreSQL с Primary и подготовит данные для последующего воспроизведения WAL.
Внимание! Cледующие команды рассчитаны на новый Standby без ценных данных. Существующий кластер PostgreSQL на втором VPS будет удалён.
Подготовка каталога данных
Сначала проверяем состояние кластера:
sudo pg_lsclusters
Останавливаем стандартный кластер:
sudo pg_ctlcluster 16 main stop
Удаляем его:
sudo pg_dropcluster --stop 16 main
В Ubuntu эта команда удаляет и каталог данных, и конфигурацию кластера. Поэтому создадим новый пустой кластер с ручным режимом запуска:
sudo pg_createcluster 16 main --start-conf=manual
Очищаем содержимое каталога данных (не удаляя саму папку), чтобы подготовить его для принятия копии с Primary:
sudo rm -rf /var/lib/postgresql/16/main/*
Вся конфигурация при этом останется в /etc/postgresql/16/main/, а у пользователя postgres сохранятся правильные права на целевую директорию.
Копирование базы через pg_basebackup
Итак, на Standby выполняем команду:
sudo -u postgres pg_basebackup \
  -h 10.10.0.11 \
  -p 5432 \
  -U replicator \
  -D /var/lib/postgresql/16/main \
  -Fp -Xs -P -R
Утилита запросит пароль replicator, который мы вводили на этапе создания пользователя.
Вот краткое описание параметров данной команды:
| Параметр |
Назначение |
-h |
Адрес Primary |
-p |
Порт подключения |
-U |
Пользователь репликации |
-D |
Каталог назначения |
-Fp |
Обычный формат файлов |
-Xs |
Потоковая передача WAL |
-P |
Отображение прогресса |
-R |
Подготовка Standby |
Продолжительность копирования зависит от объёма базы и скорости соединения между вашими VPS.
Параметр -R автоматически создаёт файл standby.signal и сохраняет настройки подключения к основному серверу в postgresql.auto.conf. Однако пароль, который мы вводили при запуске pg_basebackup, в конфигурации не сохраняется.
Чтобы резервный PostgreSQL мог самостоятельно подключаться к Primary после запуска или перезагрузки сервера, необходимо сохранить пароль пользователя replicator в специальном файле .pgpass, который мы настроим на следующем шаге.
Настройка пароля репликации
На Standby создаём файл .pgpass в домашнем каталоге системного пользователя postgres (в Ubuntu 24.04 это /var/lib/postgresql):
sudo -u postgres nano /var/lib/postgresql/.pgpass
Добавляем в него строку:
10.10.0.11:5432:*:replicator:StrongReplicationPassword
Здесь должен быть пароль, который мы задали роли replicator на Primary. Символ * в поле базы данных позволяет использовать эти учетные данные для любого подключения (включая служебные соединения репликации). Сохраняем файл и закрываем его.
Устанавливаем владельца и права для созданного файла:
sudo chown postgres:postgres /var/lib/postgresql/.pgpass
sudo chmod 600 /var/lib/postgresql/.pgpass
ВАЖНО! Если файл доступен другим пользователям, то PostgreSQL может проигнорировать его.
Проверяем параметры подключения:
sudo grep primary_conninfo \
  /var/lib/postgresql/16/main/postgresql.auto.conf
В выводе должна присутствовать строка с адресом Primary и пользователем replicator. При этом, в дальнейшем, утилита pg_basebackup может добавить в неё и другие параметры.
Запуск Standby
Проверяем наличие файла:
sudo ls -l /var/lib/postgresql/16/main/standby.signal
Затем задаём права каталога:
sudo chown -R postgres:postgres /var/lib/postgresql/16/main
sudo chmod 700 /var/lib/postgresql/16/main
Поскольку новый кластер создан с ручным режимом запуска, то изменим его на автоматический:
echo auto | sudo tee /etc/postgresql/16/main/start.conf
Вот теперь запускаем PostgreSQL:
sudo pg_ctlcluster 16 main start
Проверяем состояние:
sudo pg_lsclusters
Если запуск завершился ошибкой, то смотрим журнал:
sudo tail -n 50 /var/log/postgresql/postgresql-16-main.log
После успешного подключения Standby начнёт получать WAL с Primary. По сути это и все настройки. Но теперь нам было бы крайне желательно проверить, что вся система работает правильно.
Проверка репликации PostgreSQL
Для начала давайте проверим соединение между серверами и фактическую передачу данных.
Состояние репликации на Primary
На основном VPS выполняем:
sudo -u postgres psql -c \
"SELECT client_addr, state, sync_state
 FROM pg_stat_replication;"
Пример результата:
 client_addr |   state   | sync_state
-------------+-----------+------------
 10.10.0.12  | streaming | async
Значение streaming означает, что PostgreSQL передаёт WAL резервному серверу. Запись async показывает, что используется асинхронная репликация - то, что нам и нужно.
Если запрос возвращает пустой результат, это означает, что Standby сейчас не подключён и в таком случае нужно будет проверить все действия сначала.
Состояние на Standby
На резервном VPS выполняем:
sudo -u postgres psql -c \
"SELECT pg_is_in_recovery();"
Ожидаемый результат:
 pg_is_in_recovery
-------------------
 t
Значение t подтверждает, что PostgreSQL работает в режиме восстановления.
Проверяем процесс получения WAL:
sudo -u postgres psql -c \
"SELECT status, sender_host, sender_port
 FROM pg_stat_wal_receiver;"
Пример:
  status   | sender_host | sender_port
-----------+-------------+-------------
 streaming | 10.10.0.11  | 5432
Тест передачи данных
Теперь проверим непосредственно передачу данных между серверами. Для этого на Primary создадим тестовую базу:
sudo -u postgres createdb replication_test
Создадим в этой базе таблицу:
sudo -u postgres psql -d replication_test -c \
"CREATE TABLE replication_check (
    id SERIAL PRIMARY KEY,
    message TEXT NOT NULL
);"
И добавим в таблицу запись:
sudo -u postgres psql -d replication_test -c \
"INSERT INTO replication_check (message)
 VALUES ('Replication is working');"
Теперь на Standby выполняем запрос:
sudo -u postgres psql -d replication_test -c \
"SELECT * FROM replication_check;"
И ожидаем увидеть результат в виде той записи, что мы сделали на основном сервере:
 id |        message
----+------------------------
  1 | Replication is working
Если данные появились на резервном сервере - это успех.
Попробуем выполнить запись непосредственно на Standby:
sudo -u postgres psql -d replication_test -c \
"INSERT INTO replication_check (message)
 VALUES ('Write test');"
И в этом случае PostgreSQL должен вернуть ошибку:
ERROR: cannot execute INSERT in a read-only transaction
Так и должно быть, пока сервер работает как Standby, а это значит, что изменять данные на нём нельзя.
После теста удаляем базу на Primary:
sudo -u postgres dropdb replication_test
Удаление автоматически попадёт и на реплику.
Асинхронная и синхронная репликация PostgreSQL
В нашем примере конфигурации используется асинхронная репликация, когда Primary подтверждает транзакции без ожидания ответа от Standby. Это существенно снижает задержку записи, но при внезапном отказе основного сервера последние изменения могут оказаться потеряны.
Например, приложение записало заказ, PostgreSQL подтвердил транзакцию, а через мгновение VPS отключился. В таком случае, если WAL ещё не дошёл до Standby, после переключения на резервный сервер, нового заказа в базе этого сервера может не оказаться.
Для нивелирования таких рисков существует синхронная репликация, которая позволяет дождаться определённого подтверждения от резервного сервера перед завершением транзакции. Простое сравнение этих двух методов приведено в таблице ниже.
| Критерий |
Асинхронная |
Синхронная |
| Скорость записи |
Обычно выше |
Зависит от задержки сети |
| Ожидание Standby |
Нет |
Да |
| Потеря последних транзакций |
Возможна |
Зависит от режима подтверждения и сценария отказа |
| Отказ Standby |
Primary продолжает запись |
Подтверждение транзакций может блокироваться |
| Применение |
Обычные веб-проекты |
Системы со строгими требованиями к сохранности данных |
Поведение синхронной репликации в PostgreSQL можно настроить с помощью параметра synchronous_commit. Он определяет, на каком этапе передачи изменений резервному серверу транзакция будет считаться завершённой.
Для настройки синхронной репликации сначала нужно задать имя приложения (application_name) на резервном сервере (Standby). Для этого открываем конфигурационный файл подключения на Standby:
sudo nano /var/lib/postgresql/16/main/postgresql.auto.conf
В параметре primary_conninfo добавляем application_name=standby1:
primary_conninfo = 'host=10.10.0.11 port=5432 user=replicator application_name=standby1'
После этого перечитываем конфигурацию на Standby:
sudo pg_ctlcluster 16 main reload
Теперь на основном сервере (Primary) откройте файл конфигурации:
sudo nano /etc/postgresql/16/main/postgresql.conf
Добавьте или измените следующие параметры::
synchronous_standby_names = 'FIRST 1 (standby1)'
synchronous_commit = on
Здесь standby1 - это имя резервного сервера, которое должно быть указано в параметре application_name подключения Standby к Primary. Без настройки этого имени PostgreSQL не сможет определить нужную синхронную реплику.
Параметр synchronous_commit поддерживает несколько режимов:
| Значение |
Поведение PostgreSQL |
remote_write |
Primary ожидает подтверждения, что Standby записал WAL в файловую систему, но ещё не обязательно сохранил его на диск |
on |
Primary ожидает подтверждения, что Standby сохранил WAL на долговременное хранилище |
remote_apply |
Primary ожидает, пока Standby применит изменения и они станут видны запросам на чтение |
Например, если установить:
synchronous_commit = remote_apply
, то PostgreSQL подтвердит завершение транзакции приложению только после того, как резервный сервер получит и применит соответствующие WAL-записи.
После внесения изменений в файл postgresql.conf перечитайте конфигурацию кластера командой:
sudo pg_ctlcluster 16 main reload
Важно! Параметр synchronous_commit сам по себе не включает синхронную репликацию. Для этого также необходимо настроить synchronous_standby_names на Primary и соответствующий application_name на Standby.
Если обязательная синхронная реплика станет недоступной, то транзакции, требующие её подтверждения, могут ожидать неопределённо долго. Именно поэтому, для небольших проектов с двумя VPS, часто выбирают асинхронную репликацию, при которой основной сервер продолжает принимать записи даже при временной недоступности Standby.
Как проверить отставание реплики
Бывает, что работающая реплика может постепенно отставать от Primary. Причинами могут быть, например, перегрузка диска, медленное сетевое соединение или высокая интенсивность записи.
Для проверки отставания, на Primary-сервере выполним запрос:
sudo -u postgres psql -c "
SELECT
    client_addr,
    state,
    pg_size_pretty(
        pg_wal_lsn_diff(
            pg_current_wal_lsn(),
            replay_lsn
        )
    ) AS replication_lag
FROM pg_stat_replication;"
Пример результата:
 client_addr |   state   | replication_lag
-------------+-----------+-----------------
 10.10.0.12  | streaming | 128 kB
Этот запрос показывает разницу между текущей позицией WAL на Primary и последней известной позицией применения на Standby. При этом небольшое отставание при активной записи нормально. Но если разница постоянно увеличивается, тогда стоит проверить сеть и производительность резервного VPS. Правда стоит учитывать, что у PostgreSQL нет универсальной нормы отставания репликации. Поэтому значение в 10 МБ может быть совершенно нормальным для нагруженной базы данных и одновременно тревожным для небольшого сайта, который генерирует всего несколько мегабайт WAL в минуту.
Replication Slots как защита от потери WAL
Представим себе такой случай, когда резервный VPS, по тем или иным причинам отключился на сутки. Primary продолжал работать всё это время и продолжал создавать WAL-сегменты, да так много, что часть старых журналов уже успела удалиться за это время.
После возвращения Standby может обнаружить, что нужных WAL больше нет и тогда продолжить репликацию без восстановления недостающих журналов не получится.
Вот для таких случаев в PostgreSQL реализована поддержка слотов репликации (Replication Slots). Слот сообщает Primary, какие WAL-сегменты ещё нужны конкретной реплике, и помогает удерживать их до получения репликой.
Давайте создадим один слот.
Создание физического слота
На Primary выполняем запрос:
sudo -u postgres psql -c \
"SELECT pg_create_physical_replication_slot('standby_vps');"
На Standby добавляем параметр в конфигурацию PostgreSQL:
sudo nano /etc/postgresql/16/main/postgresql.conf
primary_slot_name = 'standby_vps'
Перезапускаем Standby командой:
sudo pg_ctlcluster 16 main restart
После этого на Primary проверяем:
sudo -u postgres psql -c "
SELECT
    slot_name,
    slot_type,
    active,
    restart_lsn
FROM pg_replication_slots;"
Если слот используется, то параметр active будет иметь значение t.
Важно понимать, что слот, созданный без немедленного резервирования WAL, начинает удерживать необходимые сегменты после начала его использования. То есть ранее удалённые журналы он вернуть не сможет.
Ограничение размера WAL
Правда у Replication Slots есть и обратная сторона. Так, если Standby долго недоступен, то Primary может удерживать WAL до заполнения диска. И чтобы ограничить этот риск, в postgresql.conf основного сервера можно задать параметр:
max_slot_wal_keep_size = 10GB
Конечно, это пример значения, которое нужно подбирать под конкретную нагрузку.
Когда объём удерживаемых WAL превышает установленный предел, PostgreSQL может удалить необходимые реплике сегменты при очередной контрольной точке. Но после этого Standby иногда приходится создавать заново.
Поэтому Replication Slots требуют контроля свободного места и для более серьёзной инфраструктуры стоит предусмотреть архивирование WAL и лавирование между рисками потери данных и конфигурацией серверов.
Переключение на резервный VPS при отказе Primary
Теперь рассмотрим ситуацию, когда основной сервер вышел из строя. В таком случае Standby можно повысить до Primary и в PostgreSQL эта операция называется Promotion.
ВАЖНО! Перед переключением нужно убедиться, что прежний Primary больше не принимает операции записи, так как если оба сервера начнут независимо обслуживать приложения, то возникнет Split-Brain: базы разойдутся, а автоматического объединения изменений PostgreSQL не выполнит.
Повышение Standby до Primary
На резервном VPS выполняем запрос:
sudo -u postgres psql -c \
"SELECT pg_promote();"
Ожидаемый результат:
 pg_promote
------------
 t
Это означает, что запрос на повышение принят.
При вызове pg_promote() PostgreSQL автоматически удаляет файл standby.signal из каталога данных и завершает режим восстановления.
Проверяем завершение операции с помощью запроса:
sudo -u postgres psql -c \
"SELECT pg_is_in_recovery();"
Результат должен измениться на:
 pg_is_in_recovery
-------------------
 f
Теперь сервер работает как самостоятельный Primary и может принимать операции записи, но вот приложение пока продолжает использовать старый адрес базы. Поэтому нам нужно перенаправить новые подключения к актуальному серверу.
Перенаправление подключений
Для подключения приложения к новому Primary можно изменить строку подключения в конфигурации самого приложения, переключить DNS-запись или использовать заранее настроенный прокси. Мы собрали самые популярные варианты перенаправления в наглядную таблицу:
| Способ |
Особенности |
| Изменение конфигурации приложения |
Просто, но иногда нужен перезапуск приложения |
| DNS |
Зависит от кеширования записей, может занять время |
| HAProxy |
Единая точка подключения с проверкой роли сервера |
| Виртуальный IP |
Требует подходящей сетевой инфраструктуры |
| Patroni |
Позволяет автоматизировать управление кластером |
Для нашего случая с двумя небольшими VPS ручное переключение вполне подходит, если проект допускает несколько минут простоя. При отказе Primary администратор проверяет состояние Standby, повышает его до основного сервера и перенаправляет подключения приложения.
Автоматический Failover сложнее, поскольку система должна отличать реальный отказ сервера от временной потери сетевого соединения. Например, такой инструмент как Patroni использует etcd или Consul для согласования ролей серверов. Для надёжной работы обычно требуется кворум из трёх участников, где решение принимается большинством голосов. Также дополнительно необходима защита от Split-Brain, чтобы два сервера не начали одновременно принимать записи. Но это мы уже углубляемся и это выходит за рамки данной статьи.
Возвращение старого Primary
После восстановления прежнего VPS его нельзя просто включить и снова подключить к репликации, так как у нового Primary уже могла появиться собственная история WAL.
Для возврата старого сервера можно использовать утилиту pg_rewind. Она позволяет синхронизировать разошедшиеся кластеры, если выполнены необходимые условия: включены контрольные суммы данных либо заранее настроен wal_log_hints, доступны нужные WAL и соблюдены требования к состоянию серверов.
Если же использовать pg_rewind невозможно, то старый Primary проще пересоздать как Standby через pg_basebackup.
Типичные ошибки репликации в PostgreSQL
Теперь давайте быстренько пробежимся по основным проблемам, с которыми вы можете столкнуться при настройке репликации. Большинство таких проблем обнаруживается уже при первоначальном подключении или после длительного отсутствия Standby.
Для этого сначала проверяем журнал:
sudo tail -n 100 /var/log/postgresql/postgresql-16-main.log
Или сообщения systemd:
sudo journalctl -u postgresql@16-main -n 100 --no-pager
Основные ошибки и возможные причины
| Ошибка |
Причина |
Что проверить |
connection refused |
PostgreSQL не слушает адрес или порт |
listen_addresses, состояние кластера |
connection timed out |
Нет сетевого соединения |
Firewall, маршрутизация, VPN |
no pg_hba.conf entry |
Подключение запрещено |
Правила pg_hba.conf |
password authentication failed |
Ошибка пароля |
Роль replicator, .pgpass |
requested WAL segment has already been removed |
Нужный WAL удалён |
WAL-архив, Replication Slots |
database system identifier differs |
Несовместимые кластеры |
Источник базовой копии |
No space left on device |
Закончился диск |
pg_wal, свободное место |
Ошибка no pg_hba.conf entry
Если PostgreSQL сообщает:
FATAL: no pg_hba.conf entry for replication connection
На Primary проверяем правило:
host replication replicator 10.10.0.12/32 scram-sha-256
После исправления перечитываем конфигурацию:
sudo pg_ctlcluster 16 main reload
При использовании NAT или VPN реальный адрес подключения может отличаться от указанного в настройках.
Ошибка password authentication failed
Сообщение:
FATAL: password authentication failed for user "replicator"
обычно означает неправильный пароль.
На Primary можно установить новый:
sudo -u postgres psql -c \
"ALTER ROLE replicator PASSWORD 'NewStrongReplicationPassword';"
Затем обновляем .pgpass на Standby:
sudo -u postgres nano /var/lib/postgresql/.pgpass
Проверяем права:
sudo stat -c '%a %U %G %n' /var/lib/postgresql/.pgpass
Ожидаемые права - 600, владелец - postgres.
Ошибка requested WAL segment has already been removed
Сообщение:
ERROR: requested WAL segment has already been removed
появляется, когда Standby запрашивает WAL, которого уже нет на Primary.
Если нужные сегменты доступны в WAL-архиве и настроено их восстановление, значит реплика может продолжить работу.
Если же журналов больше нигде нет, то обычно потребуется заново создать Standby через pg_basebackup.
PostgreSQL запущен, но репликация отсутствует
Проверяем файл:
sudo ls -l /var/lib/postgresql/16/main/standby.signal
Затем параметры подключения:
sudo grep primary_conninfo \
  /var/lib/postgresql/16/main/postgresql.auto.conf
И состояние WAL Receiver:
sudo -u postgres psql -c \
"SELECT status, sender_host
 FROM pg_stat_wal_receiver;"
Если сервер находится в режиме восстановления, но WAL Receiver не подключён, то причину чаще всего можно найти в журнале PostgreSQL.
Как поддерживать репликацию PostgreSQL в рабочем состоянии
После настройки репликации важно убедиться, что она продолжает исправно работать. Ведь успешная синхронизация при первом запуске ещё не гарантирует, что через месяц резервный сервер будет готов принять нагрузку в случае аварии.
Для повседневного контроля подойдут Prometheus с postgres_exporter и Grafana либо уже используемая система мониторинга. В первую очередь стоит отслеживать доступность обоих VPS, состояние WAL Receiver, отставание реплики, свободное место на дисках и ошибки PostgreSQL. Если используются Replication Slots, необходимо также контролировать объём удерживаемых WAL.
Допустимые пороги мониторинга зависят от требований конкретного проекта и здесь полезно ориентироваться на два показателя: RPO (Recovery Point Objective) - допустимый период потери данных, и RTO (Recovery Time Objective) - максимальное время восстановления сервиса, о которых мы уже говорили в недавних статьях. Например, для информационного сайта задержка репликации в несколько секунд может быть вполне приемлемой, тогда как для платёжной системы требования будут значительно строже.
Помимо мониторинга, стоит периодически проверять саму процедуру переключения. Для этого можно использовать отдельную тестовую инфраструктуру, где имитируется отказ Primary, выполняется Promotion резервного сервера и проверяется подключение приложения к новой основной базе.
Такие проверки особенно важны для асинхронной репликации, где сохраняется риск потери последних транзакций. Не стоит также забывать и о других возможных проблемах, таких как удалении необходимых WAL после длительного отключения Standby и возникновении Split-Brain при неправильном переключении.
Для небольшого проекта двух VPS с PostgreSQL Streaming Replication и ручным Failover обычно достаточно, если допустим кратковременный простой. Однако по мере роста нагрузки и требований к доступности эту схему можно дополнить автоматическим переключением и более развитой системой мониторинга.
При этом репликация в любом случае должна сопровождаться полноценным резервным копированием. Её главная задача - поддерживать готовый к работе экземпляр базы данных на втором сервере, чтобы при отказе основного VPS можно было восстановить работу приложения с минимальными потерями времени и данных.
Часто задаваемые вопросы
Можно ли настроить репликацию PostgreSQL 16 и PostgreSQL 17?
Для физической потоковой репликации требуется одинаковая основная версия PostgreSQL. Так, серверы с PostgreSQL 16.4 и 16.8 могут работать в одной конфигурации репликации.
А вот напрямую подключить PostgreSQL 17 как физическую реплику PostgreSQL 16, увы нельзя. Однако для обмена данными между разными основными версиями можно рассмотреть логическую репликацию.
Можно ли выполнять SQL-запросы на Standby?
Да, если включён hot_standby. Но на резервном сервере доступны только запросы на чтение. А вот операции INSERT, UPDATE и DELETE запрещены, так как длительные запросы на Standby могут конфликтовать с применением WAL, поэтому нагрузку на реплику нужно контролировать.
Что произойдёт при потере соединения между VPS?
При асинхронной репликации Primary продолжит работать, а Standby перестанет получать новые WAL. Но когда соединение восстановится, то PostgreSQL попытается продолжить синхронизацию. Правда это сработает, только в том случае, если необходимые WAL-сегменты ещё доступны.
Можно ли использовать два VPS для автоматического Failover?
Да, но потребуется дополнительная инфраструктура для принятия решений о переключении и предотвращения Split-Brain. Одна только Streaming Replication автоматическое переключение не обеспечивает.
Заменяет ли репликация резервное копирование?
Нет, так как ошибочные изменения могут попасть на оба сервера.
Для резервного копирования лучше использовать специализированные для этого инструменты.