Відмова сервера з базою даних - чи не найсерйозніший збій, який може статися в будь-якій ІТ-системі, адже він здатний зупинити весь проєкт. Якщо сам додаток іноді вдається відновити за кілька хвилин, то з базою все набагато складніше, оскільки потрібні актуальні дані, а остання резервна копія могла бути створена кілька годин тому.
Одним із найкращих способів скоротити час простою є реплікація бази даних між двома серверами, і в цій статті ми розглянемо це питання на прикладі СУБД PostgreSQL та двох VPS-серверів. Основний сервер оброблятиме запити додатка, а резервний - постійно отримуватиме зміни бази даних з основного сервера. І в разі, якщо основний VPS вийде з ладу, то резервний можна буде перевести в робочий режим.
Давайте в цій інструкції налаштуємо фізичну потокову реплікацію PostgreSQL 16 на двох VPS-серверах, що працюють на Ubuntu 24.04, після чого перевіримо передачу даних, розберемо типові помилки та підготуємо ручне перемикання на резервний VPS.
На відміну від інших наших статей - ця супроводжуватиметься мінімумом коментарів і максимумом практичних дій. Поїхали.
Як працює реплікація PostgreSQL
Для передачі змін PostgreSQL використовує так званий журнал попереднього запису - WAL (Write-Ahead Log). Коли додаток додає або змінює дані, інформація про операцію записується в WAL. Резервний сервер отримує ці записи та відтворює зміни.
Цей механізм називається Streaming Replication.
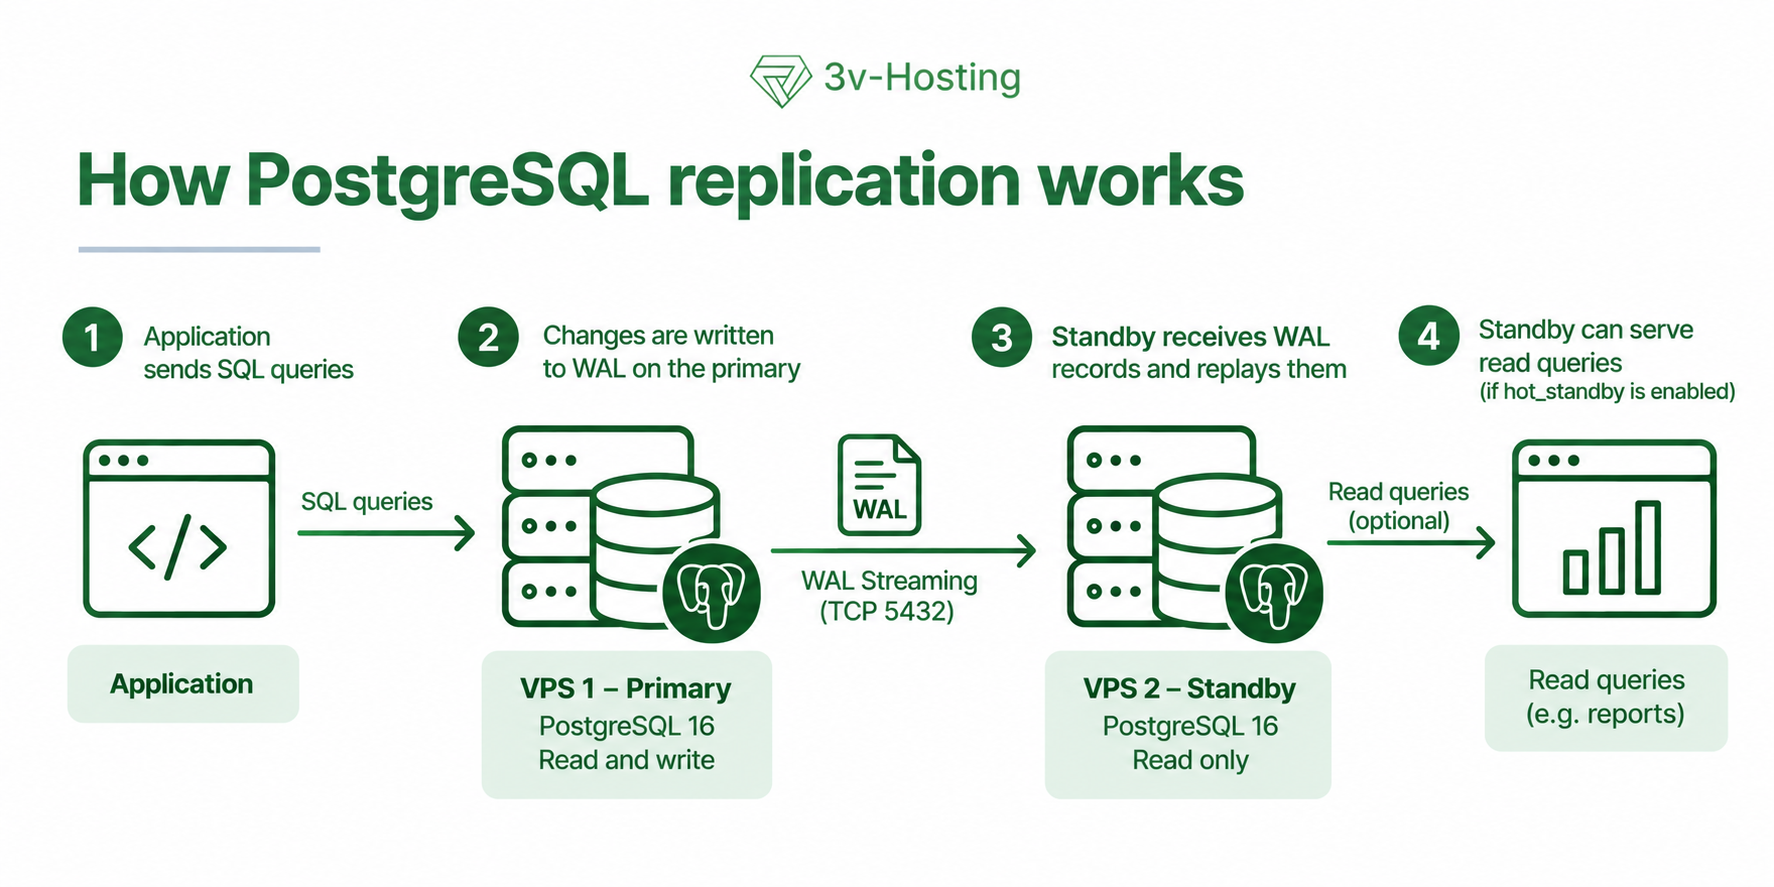
Primary приймає запити на читання та запис, а Standby отримує WAL-записи та застосовує їх до своєї копії бази.
Якщо ввімкнено параметр hot_standby (у PostgreSQL 16 він ввімкнений за замовчуванням із значенням on), то резервний сервер може обробляти запити на читання. Наприклад, на нього можна перенести формування звітів, хоча тривалі запити іноді заважають своєчасному застосуванню WAL.
Є й обмеження. Видалення таблиці, помилковий UPDATE або пошкодження даних на логічному рівні можуть потрапити на репліку. Тому для відновлення після помилок потрібні окремі резервні копії, бажано з підтримкою Point-in-Time Recovery (PITR).
Підготовка двох VPS
Для прикладу використовуємо таку конфігурацію серверів:
|
Параметр
|
Primary VPS
|
Standby VPS
|
|
IP-адреса
|
10.10.0.11
|
10.10.0.12
|
|
Операційна система
|
Ubuntu 24.04
|
Ubuntu 24.04
|
|
Версія PostgreSQL
|
16
|
16
|
|
Роль
|
Основний сервер
|
Репліка
|
|
Режим роботи
|
Читання та запис
|
Лише читання
|
|
Порт PostgreSQL
|
5432
|
5432
|
IP-адреси тут вказані умовно, але передбачається, що обидва VPS підключені до однієї приватної мережі. При цьому вкрай бажано розмістити сервери на різних фізичних вузлах, інакше несправність одного гіпервізора може одночасно відключити Primary і Standby. Ми вважаємо, що тут усе зрозуміло.
Встановлення PostgreSQL 16
На обох серверах виконуємо команди:
sudo apt update
sudo apt install postgresql-16 postgresql-client-16
Перевіряємо версію:
psql --version
Очікуваний результат:
psql (PostgreSQL) 16.x
В ОС Ubuntu база даних PostgreSQL керується через postgresql-common. Утиліта pg_lsclusters показує конкретні кластери, їхні порти та каталоги даних. Тому тепер ми можемо перевірити стан кластера за допомогою команди:
sudo pg_lsclusters
Приклад виводу:
Ver Cluster Port Status Owner    Data directory
16  main    5432 online postgres /var/lib/postgresql/16/main
Для фізичної реплікації обидва сервери повинні використовувати одну основну версію PostgreSQL. У нашому випадку - це версія 16. Мінорні версії, звичайно, можуть відрізнятися, хоча, все ж таки, оновлювати обидва екземпляри краще своєчасно.
Налаштування Primary
Почнемо налаштування з основного VPS-сервера з IP-адресою 10.10.0.11.
Зміна postgresql.conf
Відкриваємо конфігурацію:
sudo nano /etc/postgresql/16/main/postgresql.conf
Знаходимо параметри та встановлюємо значення, як зазначено нижче:
listen_addresses = “10.10.0.11,localhost”
wal_level = replica
max_wal_senders = 10
max_replication_slots = 10
wal_keep_size = 1024MB
Коротко пояснимо, що означають ці налаштування:
|
Параметр
|
Призначення
|
|
listen_addresses
|
Адреси для вхідних підключень
|
|
wal_level
|
Рівень WAL для фізичної реплікації
|
|
max_wal_senders
|
Максимальна кількість процесів передавання WAL
|
|
max_replication_slots
|
Максимальна кількість слотів реплікації
|
|
wal_keep_size
|
Мінімальний обсяг старих WAL-сегментів, що зберігаються для реплік
|
wal_keep_size = 1024MB задає мінімальний запас WAL приблизно в 1 ГБ. Це значення підходить для прикладу, але при інтенсивному записі такий запас може вичерпатися швидко.
Сам параметр не обмежує максимальний розмір каталогу pg_wal.
ВАЖЛИВО! У рамках цієї статті ми лише наводимо приклад конфігурації, а ось реальні значення параметрів для вашої системи залежатимуть від багатьох факторів, зокрема від навантаження на сервер, навантаження на базу даних, потужності самого сервера тощо.
Створення користувача для реплікації
Створимо окрему роль, через яку Standby підключатиметься до Primary.
sudo -u postgres psql
У консолі PostgreSQL виконуємо запит:
CREATE ROLE replicator
WITH REPLICATION LOGIN
PASSWORD “StrongReplicationPassword”;
ВАЖЛИВО! Замініть пароль на свій.
Роль replicator отримує право на реплікацію без повноважень суперкористувача.
Перевіряємо:
\du replicator
Виходимо:
\q
Налаштування pg_hba.conf
Тепер дозволимо підключення до нашого основного сервера з резервного VPS. Відкриваємо файл:
sudo nano /etc/postgresql/16/main/pg_hba.conf
Додаємо:
host replication replicator 10.10.0.12/32 scram-sha-256
Це правило дозволяє фізичну реплікацію користувачеві replicator з адреси 10.10.0.12. Ну і оскільки правила pg_hba.conf перевіряються зверху вниз, переконайтеся, що попередні записи не блокують це підключення.
Перезапускаємо PostgreSQL:
sudo pg_ctlcluster 16 main restart
Перевіряємо, чи запустився кластер:
sudo pg_lsclusters
Відкриття порту 5432
Якщо на Primary використовується брандмауер UFW, то нам необхідно дозволити підключення з другого VPS:
sudo ufw allow from 10.10.0.12 to any port 5432 proto tcp
Перевіряємо правила:
sudo ufw status
Очевидно, що відкривати порт 5432 для всіх адрес не потрібно - це небезпечно.
Після додавання правила, на Standby - на другому, резервному VPS, перевіряємо TCP-з’єднання з основним, Primary сервером:
nc -vz -w 3 10.10.0.11 5432
Якщо nc на сервері за замовчуванням відсутній, то встановіть його командою:
sudo apt install netcat-openbsd
У разі успішного підключення з’явиться приблизно таке повідомлення:
Connection to 10.10.0.11 5432 port [tcp/postgresql] succeeded!
Це підтверджує лише доступність конкретного порту, а ось перевірку автентифікації ми проведемо під час створення репліки.
Створення Standby на другому VPS
Тепер налаштуємо сервер 10.10.0.12.
Для отримання початкової копії бази даних використовуємо утиліту pg_basebackup. Вона скопіює файли PostgreSQL з Primary та підготує дані для подальшого відтворення WAL.
Увага! Наступні команди розраховані на новий Standby без цінних даних. Існуючий кластер PostgreSQL на другому VPS буде видалено.
Підготовка каталогу даних
Спочатку перевіряємо стан кластера:
sudo pg_lsclusters
Зупиняємо стандартний кластер:
sudo pg_ctlcluster 16 main stop
Видаляємо його:
sudo pg_dropcluster --stop 16 main
У Ubuntu ця команда видаляє і каталог даних, і конфігурацію кластера. Тому створимо новий порожній кластер із ручним режимом запуску:
sudo pg_createcluster 16 main --start-conf=manual
Очищаємо вміст каталогу даних (не видаляючи саму папку), щоб підготувати його для прийому копії з Primary:
sudo rm -rf /var/lib/postgresql/16/main/*
Уся конфігурація при цьому залишиться в /etc/postgresql/16/main/, а у користувача postgres збережуться правильні права на цільову директорію.
Копіювання бази за допомогою pg_basebackup
Отже, на Standby виконуємо команду:
sudo -u postgres pg_basebackup \
  -h 10.10.0.11 \
  -p 5432 \
  -U replicator \
  -D /var/lib/postgresql/16/main \
  -Fp -Xs -P -R
Утиліта запитає пароль replicator, який ми вводили на етапі створення користувача.
Ось короткий опис параметрів цієї команди:
|
Параметр
|
Призначення
|
|
-h
|
Адреса основного сервера
|
|
-p
|
Порт PostgreSQL
|
|
-U
|
Користувач реплікації
|
|
-D
|
Каталог для збереження базової копії
|
|
-Fp
|
Звичайний формат зберігання файлів
|
|
-Xs
|
Потокове передавання необхідних WAL-записів
|
|
-P
|
Відображення прогресу копіювання
|
|
-R
|
Автоматична підготовка конфігурації Standby
|
Тривалість копіювання залежить від обсягу бази та швидкості з’єднання між вашими VPS.
Параметр -R автоматично створює файл standby.signal та зберігає налаштування підключення до основного сервера у файлі postgresql.auto. conf. Однак пароль, який ми вводили під час запуску pg_basebackup, у конфігурації не зберігається.
Щоб резервний PostgreSQL міг самостійно підключатися до Primary після запуску або перезавантаження сервера, необхідно зберегти пароль користувача replicator у спеціальному файлі .pgpass, який ми налаштуємо на наступному кроці.
Налаштування пароля реплікації
На Standby створюємо файл .pgpass у домашньому каталозі системного користувача postgres (в Ubuntu 24.04 це /var/lib/postgresql):
sudo -u postgres nano /var/lib/postgresql/.pgpass
Додаємо до нього рядок:
10.10.0.11:5432:*: replicator:StrongReplicationPassword
Тут має бути пароль, який ми задали ролі replicator на Primary. Символ * у полі бази даних дозволяє використовувати ці облікові дані для будь-якого підключення (включно зі службовими з’єднаннями реплікації). Зберігаємо файл і закриваємо його.
Встановлюємо власника та права для створеного файлу:
sudo chown postgres:postgres /var/lib/postgresql/.pgpass
sudo chmod 600 /var/lib/postgresql/.pgpass
ВАЖЛИВО! Якщо файл доступний іншим користувачам, то PostgreSQL може його проігнорувати.
Перевіряємо параметри підключення:
sudo grep primary_conninfo \
  /var/lib/postgresql/16/main/postgresql.auto.conf
У виведенні має бути рядок з адресою Primary та користувачем replicator. При цьому, надалі, утиліта pg_basebackup може додати до нього й інші параметри.
Запуск Standby
Перевіряємо наявність файлу:
sudo ls -l /var/lib/postgresql/16/main/standby.signal
Потім задаємо права каталогу:
sudo chown -R postgres:postgres /var/lib/postgresql/16/main
sudo chmod 700 /var/lib/postgresql/16/main
Оскільки новий кластер створено з ручним режимом запуску, то змінимо його на автоматичний:
echo auto | sudo tee /etc/postgresql/16/main/start.conf
Ось тепер запускаємо PostgreSQL:
sudo pg_ctlcluster 16 main start
Перевіряємо стан:
sudo pg_lsclusters
Якщо запуск завершився помилкою, то переглядаємо журнал:
sudo tail -n 50 /var/log/postgresql/postgresql-16-main.log
Після успішного підключення Standby почне отримувати WAL від Primary. По суті, це й усі налаштування. Але тепер нам було б вкрай бажано перевірити, чи вся система працює правильно.
Перевірка реплікації PostgreSQL
Для початку давайте перевіримо з’єднання між серверами та фактичну передачу даних.
Стан реплікації на Primary
На основному VPS виконуємо:
sudo -u postgres psql -c \
"SELECT client_addr, state, sync_state
 FROM pg_stat_replication;"
Приклад результату:
 client_addr |   state   | sync_state
-------------+-----------+--------- ---
 10.10.0.12  | streaming | async
Значення streaming означає, що PostgreSQL передає WAL резервному серверу. Запис async вказує на те, що використовується асинхронна реплікація - саме те, що нам потрібно.
Якщо запит повертає порожній результат, це означає, що Standby зараз не підключений, і в такому випадку потрібно буде перевірити всі дії спочатку.
Стан на Standby
На резервному VPS виконуємо:
sudo -u postgres psql -c \
"SELECT pg_is_in_recovery();"
Очікуваний результат:
 pg_is_in_recovery
------ -------------
 t
Значення t підтверджує, що PostgreSQL працює в режимі відновлення.
Перевіряємо процес отримання WAL:
sudo -u postgres psql -c \
"SELECT status, sender_host, sender_port
 FROM pg_stat_wal_receiver;"
Приклад:
  status   | sender_host | sender_port
---------- -+-------------+-------------
 streaming | 10.10.0.11  | 5432
Тест передачі даних
Тепер перевіримо безпосередньо передачу даних між серверами. Для цього на Primary створимо тестову базу:
sudo -u postgres createdb replication_test
Створимо в цій базі таблицю:
sudo -u postgres psql -d replication_test -c \
"CREATE TABLE replication_check (
    id SERIAL PRIMARY KEY,
    message TEXT NOT NULL
);"
І додамо до таблиці запис:
sudo -u postgres psql -d replication_test -c \
"INSERT INTO replication_check (message)
 VALUES (“Replication is working”);"
Тепер на Standby виконуємо запит:
sudo -u postgres psql -d replication_test -c \
"SELECT * FROM replication_check;"
І очікуємо побачити результат у вигляді того запису, який ми зробили на основному сервері:
 id |        message
----+------------------------  1 | Replication is working
Якщо дані з’явилися на резервному сервері - це успіх.
Спробуємо виконати запис безпосередньо на Standby:
sudo -u postgres psql -d replication_test -c \
"INSERT INTO replication_check (message)
 VALUES (“Write test”);"
І в цьому випадку PostgreSQL має повернути помилку:
ERROR: cannot execute INSERT in a read-only transaction
Так і має бути, доки сервер працює як Standby, а це означає, що змінювати дані на ньому не можна.
Після тесту видаляємо базу на Primary:
sudo -u postgres dropdb replication_test
Видалення автоматично пошириться й на репліку.
Асинхронна та синхронна реплікація PostgreSQL
У нашому прикладі конфігурації використовується асинхронна реплікація, коли Primary підтверджує транзакції, не чекаючи відповіді від Standby. Це суттєво зменшує затримку запису, але в разі раптової відмови основного сервера останні зміни можуть бути втрачені.
Наприклад, додаток записав замовлення, PostgreSQL підтвердив транзакцію, а за мить VPS відключився. У такому випадку, якщо WAL ще не дійшов до Standby, після перемикання на резервний сервер нового замовлення в базі цього сервера може не виявитися.
Для мінімізації таких ризиків існує синхронна реплікація, яка дозволяє дочекатися певного підтвердження від резервного сервера перед завершенням транзакції. Просте порівняння цих двох методів наведено в таблиці нижче.
|
Критерій
|
Асинхронна
|
Синхронна
|
|
Підтвердження транзакції
|
Не очікує підтвердження від Standby
|
Очікує заданого рівня підтвердження
|
|
Затримка запису
|
Зазвичай нижча
|
Залежить від затримки мережі та режиму підтвердження
|
|
Ризик втрати останніх транзакцій у разі відмови Primary
|
Можливий
|
Залежить від конфігурації та сценарію відмови
|
|
Недоступність Standby
|
Primary продовжує роботу
|
Може блокувати завершення транзакцій
|
|
Типові сценарії
|
Сайти, SaaS, вебзастосунки
|
Системи із суворими вимогами до збереження транзакцій
|
Поведінку синхронної реплікації в PostgreSQL можна налаштувати за допомогою параметра synchronous_commit. Він визначає, на якому етапі передачі змін на резервний сервер транзакція вважатиметься завершеною.
Для налаштування синхронної реплікації спочатку потрібно вказати ім’я додатка (application_name) на резервному сервері (Standby). Для цього відкриваємо файл конфігурації підключення на Standby:
sudo nano /var/lib/postgresql/16/main/postgresql.auto.conf
У параметрі primary_conninfo додаємо application_name=standby1:
primary_conninfo = “host=10.10.0.11 port=5432 user=replicator application_name=standby1”
Після цього перезавантажуємо конфігурацію на Standby:
sudo pg_ctlcluster 16 main reload
Тепер на основному сервері (Primary) відкрийте файл конфігурації:
sudo nano /etc/postgresql/16/main/postgresql.conf
Додайте або змініть такі параметри:
synchronous_standby_names = “FIRST 1 (standby1)”
synchronous_commit = on
Тут standby1 - це ім’я резервного сервера, яке має бути вказане в параметрі application_name підключення Standby до Primary. Без налаштування цього імені PostgreSQL не зможе визначити потрібну синхронну репліку.
Параметр synchronous_commit підтримує кілька режимів:
|
Значення
|
Поведінка PostgreSQL
|
|
remote_write
|
Primary очікує підтвердження, що Standby записав WAL у файлову систему, але ще не обов'язково зберіг його на диск
|
|
on
|
Primary очікує підтвердження, що Standby зберіг WAL на довготривалому сховищі
|
|
remote_apply
|
Primary очікує, поки Standby застосує зміни і вони стануть видимими для запитів на читання
|
Наприклад, якщо встановити:
synchronous_commit = remote_apply
, то PostgreSQL підтвердить завершення транзакції додатку лише після того, як резервний сервер отримає та застосує відповідні записи WAL.
Після внесення змін до файлу postgresql.confперезавантажте конфігурацію кластера командою:
sudo pg_ctlcluster 16 main reload
Важливо! Параметр synchronous_commitсам по собі не вмикає синхронну реплікацію. Для цього також необхідно налаштувати synchronous_standby_namesна Primary та відповідний application_nameна Standby.
Якщо обов’язкова синхронна реплікація стане недоступною, то транзакції, що вимагають її підтвердження, можуть очікувати невизначено довго. Саме тому для невеликих проєктів із двома VPS часто обирають асинхронну реплікацію, під час якої основний сервер продовжує приймати записи навіть у разі тимчасової недоступності Standby.
Як перевірити відставання репліки
Буває, що репліка, яка працює, може поступово відставати від Primary. Причинами можуть бути, наприклад, перевантаження диска, повільне мережеве з’єднання або висока інтенсивність запису.
Щоб перевірити відставання, на Primary-сервері виконаємо запит:
sudo -u postgres psql -c "
SELECT
    client_addr,
    state,
    pg_size_pretty(
        pg_wal_lsn_diff(
            pg_current_wal_lsn(),
            replay_lsn
        )
    ) AS replication_lag
FROM pg_stat_replication;"
Приклад результату:
 client_addr |   state   | replication_lag
-------------+-----------+-----------------
 10.10.0.12  | streaming | 128 kB
Цей запит показує різницю між поточною позицією WAL на Primary та останньою відомою позицією застосування на Standby. При цьому невелике відставання під час активного запису є нормальним. Але якщо різниця постійно збільшується, тоді варто перевірити мережу та продуктивність резервного VPS. Щоправда, слід враховувати, що у PostgreSQL немає універсальної норми відставання реплікації. Тому значення в 10 МБ може бути цілком нормальним для навантаженої бази даних і водночас тривожним для невеликого сайту, який генерує всього кілька мегабайтів WAL за хвилину.
Replication Slots як захист від втрати WAL
Уявімо собі такий випадок, коли резервний VPS з тих чи інших причин відключився на добу. Primary продовжував працювати весь цей час і створювати WAL-сегменти, причому так багато, що частина старих журналів вже встигла видалитися за цей час.
Після повернення Standby може виявити, що потрібних WAL більше немає, і тоді продовжити реплікацію без відновлення відсутніх журналів не вийде.
Ось для таких випадків у PostgreSQL реалізовано підтримку слотів реплікації (Replication Slots). Слот повідомляє Primary, які WAL-сегменти ще потрібні конкретній репліці, і допомагає утримувати їх до отримання реплікою.
Давайте створимо один слот.
Створення фізичного слота
На Primary виконуємо запит:
sudo -u postgres psql -c \
"SELECT pg_create_physical_replication_slot(“standby_vps”);"
На Standby додаємо параметр до конфігурації PostgreSQL:
sudo nano /etc/postgresql/16/main/postgresql.conf
primary_slot_name = “standby_vps”
Перезапускаємо Standby командою:
sudo pg_ctlcluster 16 main restart
Після цього на Primary перевіряємо:
sudo -u postgres psql -c "
SELECT    slot_name,
    slot_type,
    active,
    restart_lsn
FROM pg_replication_slots;"
Якщо слот використовується, то параметр active матиме значення t.
Важливо розуміти, що слот, створений без негайного резервування WAL, починає зберігати необхідні сегменти після початку його використання. Тобто раніше видалені журнали він повернути не зможе.
Обмеження розміру WAL
Щоправда, у Replication Slots є й зворотний бік. Так, якщо Standby тривалий час недоступний, то Primary може зберігати WAL до заповнення диска. І щоб обмежити цей ризик, у postgresql.conf основного сервера можна задати параметр:
max_slot_wal_keep_size = 10GB
Звісно, це приклад значення, яке потрібно підбирати під конкретне навантаження.
Коли обсяг збережених WAL перевищує встановлену межу, PostgreSQL може видалити сегменти, необхідні для реплікації, під час чергової контрольної точки. Але після цього Standby іноді доводиться створювати заново.
Тому Replication Slots вимагають контролю вільного місця, і для більш серйозної інфраструктури варто передбачити архівування WAL та пошук компромісу між ризиками втрати даних і конфігурацією серверів.
Перемикання на резервний VPS у разі відмови Primary
Тепер розглянемо ситуацію, коли основний сервер вийшов з ладу. У такому випадку Standby можна підвищити до Primary, і в PostgreSQL ця операція називається Promotion.
ВАЖЛИВО! Перед перемиканням потрібно переконатися, що колишній Primary більше не приймає операції запису, оскільки якщо обидва сервери почнуть незалежно обслуговувати додатки, то виникне Split-Brain: бази розійдуться, а автоматичного об’єднання змін PostgreSQL не виконає.
Підвищення Standby до Primary
На резервному VPS виконуємо запит:
sudo -u postgres psql -c \
"SELECT pg_promote();"
Очікуваний результат:
 pg_promote
-------- ----
 t
Це означає, що запит на підвищення прийнято.
При виклику pg_promote() PostgreSQL автоматично видаляє файл standby.signal з каталогу даних і завершує режим відновлення.
Перевіряємо завершення операції за допомогою запиту:
sudo -u postgres psql -c \
"SELECT pg_is_in_recovery();"
Результат має змінитися на:
 pg_is_in_recovery
-------------------
 f
Тепер сервер працює як самостійний Primary і може приймати операції запису, але додаток поки що продовжує використовувати стару адресу бази. Тому нам потрібно перенаправити нові підключення до актуального сервера.
Перенаправлення підключень
Щоб підключити додаток до нового Primary, можна змінити рядок підключення в конфігурації самого додатка, перенаправити DNS-запис або використовувати заздалегідь налаштований проксі-сервер. Ми зібрали найпопулярніші варіанти перенаправлення в наочну таблицю:
|
Спосіб
|
Особливості
|
|
Зміна конфігурації застосунку
|
Просто, але іноді потрібен перезапуск застосунку
|
|
DNS
|
Залежить від кешування записів, може потребувати певного часу
|
|
HAProxy
|
Єдина точка підключення з перевіркою ролі сервера
|
|
Віртуальна IP-адреса
|
Потребує відповідної мережевої інфраструктури
|
|
Patroni
|
Дозволяє автоматизувати керування кластером
|
Для нашого випадку з двома невеликими VPS ручне перемикання цілком підходить, якщо проект допускає кілька хвилин простою. У разі відмови Primary адміністратор перевіряє стан Standby, підвищує його до рівня основного сервера та перенаправляє з’єднання додатка.
Автоматичний Failover складніший, оскільки система має відрізняти реальну відмову сервера від тимчасової втрати мережевого з’єднання. Наприклад, такий інструмент, як Patroni, використовує etcd або Consul для узгодження ролей серверів. Для надійної роботи зазвичай потрібен кворум із трьох учасників, де рішення ухвалюється більшістю голосів. Також додатково необхідний захист від Split-Brain, щоб два сервери не почали одночасно приймати записи. Але це вже заглиблення в тему, яке виходить за межі цієї статті.
Повернення старого Primary
Після відновлення колишнього VPS його не можна просто увімкнути й знову підключити до реплікації, оскільки у нового Primary вже могла з’явитися власна історія WAL.
Для повернення старого сервера можна використовувати утиліту pg_rewind. Вона дозволяє синхронізувати кластери, що розійшлися, якщо виконано необхідні умови: увімкнено контрольні суми даних або заздалегідь налаштовано wal_log_hints, доступні потрібні WAL і дотримано вимог до стану серверів.
Якщо ж використовувати pg_rewind неможливо, то старий Primary простіше перестворити як Standby за допомогою pg_basebackup.
Типові помилки реплікації в PostgreSQL
Тепер давайте швидко розглянемо основні проблеми, з якими ви можете зіткнутися під час налаштування реплікації. Більшість таких проблем виявляється вже під час початкового підключення або після тривалої відсутності Standby.
Для цього спочатку перевіряємо журнал:
sudo tail -n 100 /var/log/postgresql/postgresql-16-main.log
Або повідомлення systemd:
sudo journalctl -u postgresql@16-main -n 100 --no-pager
Основні помилки та можливі причини
|
Помилка
|
Причина
|
Що перевірити
|
|
connection refused
|
PostgreSQL не прослуховує адресу або порт
|
listen_addresses, стан кластера
|
|
connection timed out
|
Відсутнє мережеве з'єднання
|
Firewall, маршрутизацію, VPN
|
|
no pg_hba.conf entry
|
Підключення заборонено
|
Правила pg_hba.conf
|
|
password authentication failed
|
Неправильний пароль
|
Роль replicator, .pgpass
|
|
requested WAL segment has already been removed
|
Необхідний WAL-сегмент видалено
|
WAL-архів, Replication Slots
|
|
database system identifier differs
|
Несумісні кластери
|
Джерело базової копії
|
|
No space left on device
|
Закінчилося місце на диску
|
pg_wal, вільне місце
|
Помилка: немає запису в pg_hba.conf
Якщо PostgreSQL повідомляє:
FATAL: немає запису в pg_hba.conf для з’єднання реплікації
На Primary перевіряємо правило:
host replication replicator 10.10.0.12/32 scram-sha-256
Після виправлення перезавантажуємо конфігурацію:
sudo pg_ctlcluster 16 main reload
При використанні NAT або VPN реальна адреса підключення може відрізнятися від зазначеної в налаштуваннях.
Помилка password authentication failed
Повідомлення:
FATAL: password authentication failed for user "replicator"
зазвичай означає неправильний пароль.
На Primary можна встановити новий:
sudo -u postgres psql -c \
"ALTER ROLE replicator PASSWORD “NewStrongReplicationPassword”;"
Потім оновлюємо .pgpass на Standby:
sudo -u postgres nano /var/lib/postgresql/.pgpass
Перевіряємо права:
sudo stat -c "%a %U %G %n" /var/lib/postgresql/.pgpass
Очікувані права - 600, власник - postgres.
Помилка: запитуваний сегмент WAL вже видалено
Повідомлення:
ERROR: requested WAL segment has already been removed
з’являється, коли Standby запитує WAL, якого вже немає на Primary.
Якщо потрібні сегменти доступні в архіві WAL і налаштовано їх відновлення, то репліка може продовжити роботу.
Якщо ж журналів більше ніде немає, то зазвичай потрібно заново створити Standby за допомогою pg_basebackup.
PostgreSQL запущено, але реплікація відсутня
Перевіряємо файл:
sudo ls -l /var/lib/postgresql/16/main/standby.signal
Потім параметри підключення:
sudo grep primary_conninfo \ /var/lib/postgresql/16/main/postgresql.auto.conf
І стан WAL Receiver:
sudo -u postgres psql -c \
"SELECT status, sender_host
 FROM pg_stat_wal_receiver;"
Якщо сервер перебуває в режимі відновлення, але WAL Receiver не підключений, то причину найчастіше можна знайти в журналі PostgreSQL.
Як підтримувати реплікацію PostgreSQL у робочому стані
Після налаштування реплікації важливо переконатися, що вона продовжує справно працювати. Адже успішна синхронізація під час першого запуску ще не гарантує, що через місяць резервний сервер буде готовий прийняти навантаження у разі аварії.
Для щоденного контролю підійдуть Prometheus із postgres_exporter та Grafana або система моніторингу, яка вже використовується. Насамперед варто відстежувати доступність обох VPS, стан WAL Receiver, відставання репліки, вільне місце на дисках та помилки PostgreSQL. Якщо використовуються Replication Slots, необхідно також контролювати обсяг утримуваних WAL.
Допустимі порогові значення моніторингу залежать від вимог конкретного проєкту, і тут корисно орієнтуватися на два показники: RPO (Recovery Point Objective) - допустимий період втрати даних, та RTO (Recovery Time Objective) - максимальний час відновлення сервісу, про які ми вже говорили в недавніх статтях. Наприклад, для інформаційного сайту затримка реплікації в кілька секунд може бути цілком прийнятною, тоді як для платіжної системи вимоги будуть значно суворішими.
Окрім моніторингу, варто періодично перевіряти саму процедуру перемикання. Для цього можна використовувати окрему тестову інфраструктуру, де імітується відмова Primary, виконується Promotion резервного сервера та перевіряється підключення додатка до нової основної бази.
Такі перевірки особливо важливі для асинхронної реплікації, де зберігається ризик втрати останніх транзакцій. Не варто також забувати й про інші можливі проблеми, такі як видалення необхідних WAL після тривалого відключення Standby та виникнення Split-Brain у разі неправильного перемикання.
Для невеликого проєкту з двох VPS із PostgreSQL Streaming Replication та ручним Failover зазвичай достатньо, якщо допустити короткочасний простой. Однак у міру зростання навантаження та вимог до доступності цю схему можна доповнити автоматичним перемиканням та більш розвиненою системою моніторингу.
При цьому реплікація в будь-якому разі має супроводжуватися повноцінним резервним копіюванням. Її головне завдання - підтримувати готовий до роботи екземпляр бази даних на другому сервері, щоб у разі відмови основного VPS можна було відновити роботу додатка з мінімальними втратами часу та даних.
Поширені запитання
Чи можна налаштувати реплікацію PostgreSQL 16 і PostgreSQL 17?
Для фізичної потокової реплікації потрібна однакова основна версія PostgreSQL. Так, сервери з PostgreSQL 16.4 і 16.8 можуть працювати в одній конфігурації реплікації.
А ось безпосередньо підключити PostgreSQL 17 як фізичну репліку PostgreSQL 16, на жаль, неможливо. Однак для обміну даними між різними основними версіями можна розглянути логічну реплікацію.
Чи можна виконувати SQL-запити на Standby?
Так, якщо увімкнено hot_standby. Але на резервному сервері доступні лише запити на читання. А ось операції INSERT, UPDATE та DELETE заборонені, оскільки тривалі запити на Standby можуть конфліктувати із застосуванням WAL, тому навантаження на репліку потрібно контролювати.
Що станеться у разі втрати з’єднання між VPS?
При асинхронній реплікації Primary продовжить працювати, а Standby перестане отримувати нові WAL. Але коли з’єднання відновиться, PostgreSQL спробує продовжити синхронізацію. Щоправда, це спрацює лише в тому випадку, якщо необхідні WAL-сегменти ще доступні.
Чи можна використовувати два VPS для автоматичного Failover?
Так, але знадобиться додаткова інфраструктура для прийняття рішень щодо перемикання та запобігання Split-Brain. Сама лише Streaming Replication автоматичного перемикання не забезпечує.
Чи замінює реплікація резервне копіювання?
Ні, оскільки помилкові зміни можуть потрапити на обидва сервери.
Для резервного копіювання краще використовувати спеціалізовані для цього інструменти.